详解Linux下内存使用及释放
最近频频遇到系统负载不高且当下也没有大量的 IO 操作,但是内存使用率却较高的情况。 因此有必要仔细研究下 Linux 下的内存管理机制,其他类 Unix 平台也多少大同小异,但是也不可一概而论,待时间充裕再比较分析其他系统下的内存管理机制。
首先 Linux 同时涉及 虚拟地址空间 和 物理内存区域 两个层次。同时 用户空间与内核空间则属于虚拟地址空间的划分,而在物理上又被分为三块:ZONE_DMA,ZONE_NORMAL 和ZONE_HIGH。这里的 ZONE_DMA 是可直接存取访问的内存区域,即不需要任何的逻辑映射,大小为 0~16MiB;ZONE_NORAML 为内核所保留使用的,其大小为16~896MiB;剩下的 896~End 都是 ZONE_HIGH 的区域,该段区域是应用程序进行 malloc() 时所能访问的地址(当然应用程序可以通过系统调用来访问 ZONE_NORMAL 区域)。说完内存的映射,那么就应该讲解操作系统如何管理内存了——**内存的分配与回收:**内存的分配在 kernel 中是通过 Buddy 算法(即伙伴算法)来做统一分配的,伙伴系统能够在一定程度上缓解外部碎片,并通过伙伴合并提高连续物理内存分配的成功率,从而在很大程度上提高了内存的使用效率(但无法完全消除内存碎片);内存回收则是通过 LRU 算法,即基于最近最少使用算法来进行回收的。LRU 算法的核心思想是:如果资源已较长时间未使用了,那么在最近的某段时间内,该资源用到的可能性也几乎是不可能的。同时内核维护着两张链表,分别为 Active 和 Inactive 链表,当进程不再活动或是分配的内存已不再使用时,内存将有原 Active 链表移到 Inactive 链表尾部,当操作系统发现有必要进行内存回收时,将由 Inactive 链表表头开始,从而保证所回收的内存地址空间确实是不再使用并且可以进行回收的。
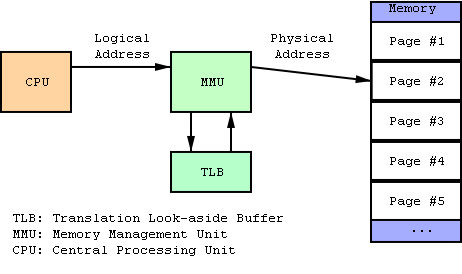
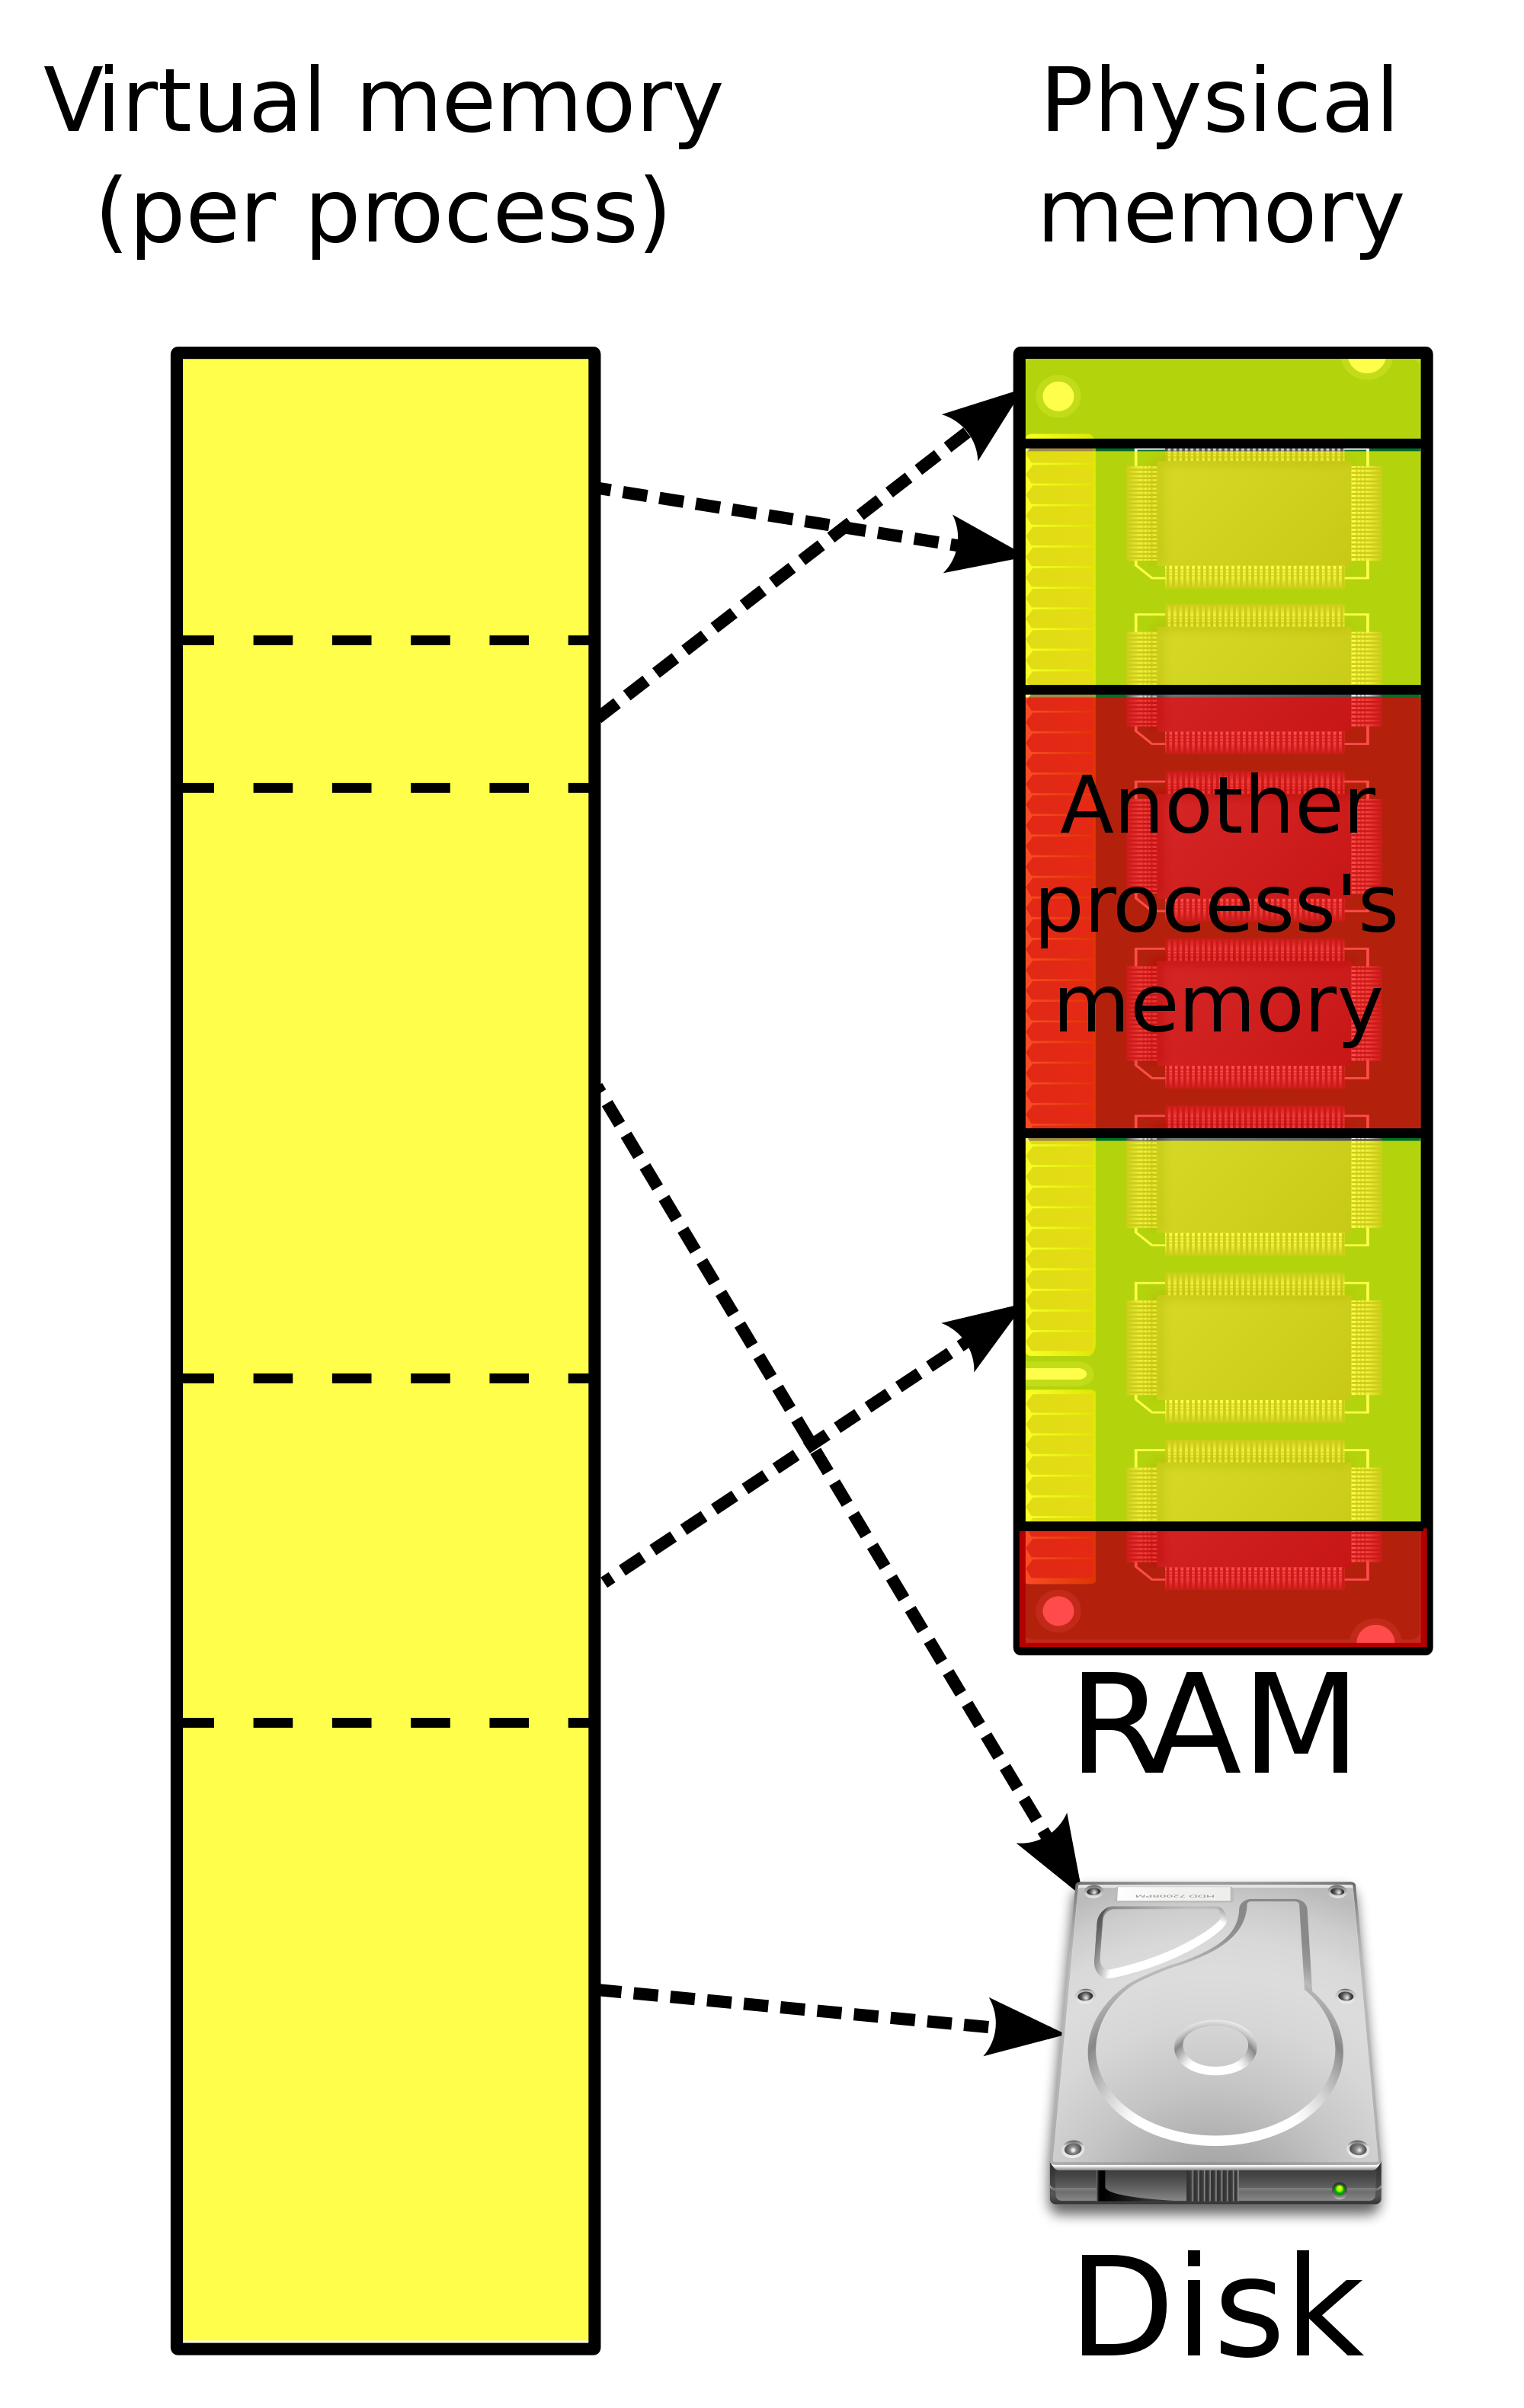
那么知道内存的划分与分配回收算法,剩下的就是内核具体如何分配和回收的问题了。内存的管理在 kernel 中是 VM(Virtual Memory)子系统承担的。VM 主要做两件事:线性映射 和 动态释放。线性映射即将用户态的物理内存映射为逻辑上线性连续的内存空间,然后当应用程序申请内存时将其分配给应用,而申请操作是由应用程序自身发起的,常见的即 malloc();动态释放即内存的回收,内存回收在内核中由线程 kswapd 完成。kswapd 是 Linux 内核创建的后台内核线程,负责在内存压力达到一定条件时执行后台内存平衡和回收。其具体实例和作用范围与内存节点、内核配置等有关,其虽然没有独立的内存空间但也占用非常少量的内存,kswapd 的运行方式有两种:内核主动调用 和 时钟源中断。时钟中断即每若干时钟滴答后,kswapd 即由 wakeup_kswapd 进行唤醒;第二种方式是当可用内存低于一定的水位后,由内核主动发生调用。如下图所示:
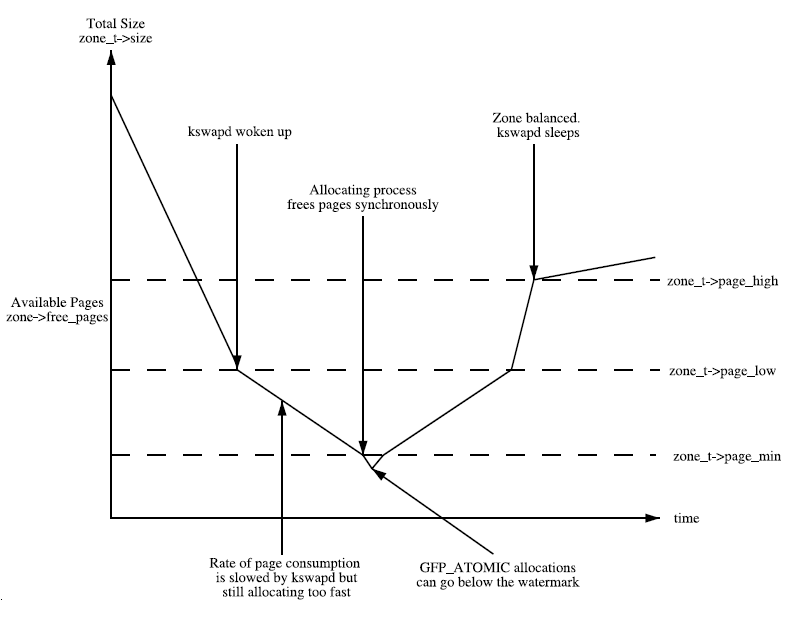
那么具体地,这些水位的值该如何计算呢?核心代码其实在 /mm/page_alloc.c 中,我们来简单地看下(暂时只关心 ZONE_HIGHMEM部分,因为这部分才是和我们的应用程序息息相关的):
2242         zone->pages_low   = zone->pages_min + (tmp >> 2);
2243         zone->pages_high  = zone->pages_min + (tmp >> 1);
2244         spin_unlock_irqrestore(&zone->lru_lock, flags);
在代码的 2242~2244 行,说明了 zone->pages_high 的计算方式,这里涉及到两个值:zone->pages_min 和 tmp,只要我们知道这两个值便可轻松地得到具体的内存回收水位的阈值了。
2228             min_pages = zone->present_pages / 1024;
2229             if (min_pages < SWAP_CLUSTER_MAX)
2230                 min_pages = SWAP_CLUSTER_MAX;
2231             if (min_pages > 128)
2232                 min_pages = 128;
2233             zone->pages_min = min_pages;
2234         } else {
2235             /*
2236              * If it's a lowmem zone, reserve a number of pages
2237              * proportionate to the zone's size.
2238              */
2239             zone->pages_min = tmp;
2240         }
在代码的 2229~2240 行,说明了如果当前处于 ZONE_HIGHMEM 的话,那么 zone->pages_min 的值应该就是 min_pages,而min_pages 的值是当前ZONE的所有页数整除 1024,且介于 **(SWAP_CLUSTER_MAX,128)**之间。那么我们不妨放大一下,取128。那么现在就剩下tmp的值未知了。
2213         spin_lock_irqsave(&zone->lru_lock, flags);
2214         tmp = (u64)pages_min * zone->present_pages;
2215         do_div(tmp, lowmem_pages);
从该文件的 2213~2215 行,可知 tmp 的值为 pages_min * zone->present_pages 并且对 lowmem_pages 取整(do_div 是第一个参数对第二个参数取整,第一个参数以指针的方式进行传递),此时的 pages_min 值并不是我们上面计算得到的,还要通过代码进一步观察:
2197 void setup_per_zone_pages_min(void)
2198 {
2199     unsigned long pages_min = min_free_kbytes >> (PAGE_SHIFT - 10);
2200     unsigned long lowmem_pages = 0;
从代码的 2197~2200 行可知,pages_min = min_free_kbytes >> (PAGE_SHIFT – 10),那么 min_free_kbytes 和 PAGE_SHIFT 又是多少呢?我们知道在 x86 和 x86_64 架构下,Linux 的一个页大小是 4K,即 4096,那么也就是 2^PAGE_SHIFT=4096,所以PAGE_SHIFT 为 12。
2251 /*
2252  * Initialise min_free_kbytes.
2253  *
2254  * For small machines we want it small (128k min).  For large machines
2255  * we want it large (64MB max).  But it is not linear, because network
2256  * bandwidth does not increase linearly with machine size.  We use
2257  *
2258  *  min_free_kbytes = 4 * sqrt(lowmem_kbytes), for better accuracy:
2259  *  min_free_kbytes = sqrt(lowmem_kbytes * 16)
2260  *
2261  * which yields
2262  *
2263  * 16MB:    512k
2264  * 32MB:    724k
2265  * 64MB:    1024k
2266  * 128MB:   1448k
2267  * 256MB:   2048k
2268  * 512MB:   2896k
2269  * 1024MB:  4096k
2270  * 2048MB:  5792k
2271  * 4096MB:  8192k
2272  * 8192MB:  11584k
2273  * 16384MB: 16384k
2274  */
从 2251~2274 的注释中我们可以得知 min_free_kbytes 的计算方式和具体内存所对应的 min_free_kbytes 值,以 8G 内存为例,此时 min_free_kbytes 为 11584k。那么剩下的就是 lowmem_pages了:
2205     for_each_zone(zone) {
2206         if (!is_highmem(zone))
2207             lowmem_pages += zone->present_pages;
2208     }
由代码的 2205~2208 行可知,lowmem_pages 为 ZONE_DMA 和 ZONE_NORMAL 二者内存拥有的页数总和,即 lowmem_pages = 896*1024/4。
至此,所有的值均得到了(以系统拥有8G内存为例),那么:
 zone->present_pages = (8192-896)*1024/4
 min_free_kbytes = 11584
 pages_min = 2896(此值是为计算tmp的值通过min_free_kbytes >> (PAGE_SHIFT – 10)而算得的
因此 tmp = 2896*1867776,然后再经一次 do_div(tmp, lowmem_pages),那么对于 ZONE_HIGHMEM 而言 tmp 的真实值为 23581。而该值是页数,我们再将其转换为更易理解的兆字节(MiB)是:92MiB。
8GiB 的内存下,如果进程不释放,那么当可用内存(ZONE_HIGHMEM)小于 92MB 的时候,操作系统才会进行内存回收!这和我们经验有很大出入。作者在自己的虚拟机上进行验证后,发现当内存为 2G 的时候,可用内存小于 50MB 的时候,内核才会触发 kswapd 进行内存回收。而且通过在 RHEL 5.8 x86_84 上演示发现:当 demo2 程序一直向操作系统申请内存时,操作系统总是响应并且在内存不足时是会动用 swap 分区;但是在 RHEL 6.3 x86 上演示发现操作系统并不是总是响应 demo2 的内存申请动作,而且也并不会动用 swap 分区。同样不管里 5.8 还是 6.3 当内存低于阈值时内核都会启用 kswapd 线程进行内存回收。一个明显的区别就是 5.8 在进行内存回收的同时会继续响应 demo2 进程的内存申请动作并动用 swap 分区并最终发生 OOM 事件,通过查看 syslog 日志也可发现当操作系统内存不足时,内核会多次尝试 kill 进程,不管是demo2进程(即演示进行内存申请的进程)还是其他诸如 mysqld 守护进程等;而 6.3 情况则较好,在后期内存不足时会尝试进行内存回收并当一直回收不到足够内存时会将 demo2 进程杀掉,从而避免了OOM。
最后,有一点需要说明的就是 *nix 的理念任何:Linux 会尽可能利用空闲内存进行缓存等用途,但合理的空闲内存和回收水位对于应对突发分配、降低延迟以及维持系统稳定性同样重要,不能仅以空闲内存的多少判断系统内存利用率或性能。 因此,如果在查看系统瓶颈和压力方面单纯地看内存是完全没有必要和行不通的,必须通过CPU、内存和磁盘IO三者数据综合起来看。
补充#
2026-09-19 对原文中明显的错别字做了校正。
以下是当时组内分享的讲稿。